Sommaire
- Les fondements d’un essai clinique fiable
- Hiérarchie des preuves et biais des essais
- Du résultat statistique à la décision clinique
- Reconnaître un essai clinique légitime
- Réglementation et accès aux essais cliniques
- Foire aux questions
Un essai clinique bien conduit reste la preuve la plus solide en médecine, mais tout dépend de ce « bien conduit » : contrôle, randomisation, aveugle, enregistrement préalable et déclaration des conflits d’intérêts séparent un protocole fiable d’un essai qui peut être manipulé, volontairement ou non. Repérer ces critères ne demande pas de formation médicale, seulement de savoir où regarder. C’est justement l’objectif de cet article : vous donner les repères simples pour distinguer une preuve solide d’une preuve à prendre avec précaution.
Les fondements d’un essai clinique fiable
Avant qu’un médicament arrive jusqu’à vous, il traverse un long parcours. D’abord des tests en laboratoire, puis sur des modèles animaux : cette étape préclinique dure généralement d’un à cinq ans. Ensuite seulement vient l’essai clinique, la phase où l’on teste le traitement chez des personnes pour vérifier qu’il est à la fois sûr (l’innocuité) et efficace. Et dès avant l’arrivée du premier volontaire, la qualité de tout l’essai se joue déjà : elle dépend de choix méthodologiques précis, ceux-là mêmes qui font la différence entre une preuve solide et une preuve fragile.
Cette rigueur méthodologique n’a pas toujours été respectée. C’est justement ce que documente l’ouvrage la manipulation derrière la pandémie, publié aux Éditions marco pietteur, qui replace ces questions dans leur contexte politique et médiatique.
Contrôle, randomisation et aveugle
Trois ingrédients rendent un essai clinique digne de confiance : le contrôle, la randomisation et l’aveugle. Concrètement, un essai sérieux compare toujours deux groupes en même temps : l’un reçoit le médicament testé, l’autre reçoit un placebo (un faux traitement) ou le traitement habituel. Pourquoi cette comparaison est-elle indispensable ? Parce que sans elle, impossible de savoir si une amélioration vient vraiment du médicament, ou simplement du temps qui passe, du hasard, ou même de l’attention reçue pendant l’étude, un effet bien réel qu’on appelle l’effet placebo.
La randomisation, c’est le tirage au sort qui décide qui va dans quel groupe. Elle rend les deux groupes comparables dès le départ, au moins sur le plan statistique. L’aveugle, lui, limite l’influence des attentes conscientes et inconscientes : dans un essai en double aveugle, ni les participants ni les chercheurs qui recueillent les données ne savent qui a reçu le vrai traitement.
- Groupe contrôle : il reçoit un placebo ou le traitement de référence, dans des conditions identiques à celles du groupe qui reçoit le nouveau médicament, à un détail près, la substance testée.
- Randomisation : en tirant au sort qui va dans quel groupe, on évite qu’une différence observée à la fin de l’essai vienne d’un déséquilibre de départ (par exemple, des patients plus jeunes ou en meilleure santé dans un groupe que dans l’autre) plutôt que du traitement lui-même.
- Double aveugle : personne, ni les participants ni les chercheurs qui recueillent les données, ne sait qui a reçu quoi. Cela évite que les attentes de chacun, même inconscientes, influencent les résultats.
Le placebo doit ressembler en tout point au vrai médicament : même comprimé, même apparence, même mode d’administration. Un comprimé de sucre ou une injection sans principe actif doit reproduire exactement la forme du produit testé. Pourquoi ce détail compte-t-il autant ? Parce que si les participants devinent leur groupe, l’effet placebo risque de fausser le résultat.
Effectif et analyse des essais cliniques de médicaments
Combien de patients faut-il pour qu’un essai clinique de médicaments soit crédible ? La réponse se calcule avant même de commencer, et ce n’est pas un détail technique secondaire : c’est ce qui distingue un vrai résultat d’un simple coup de chance. Les chercheurs doivent préciser à l’avance ce qu’ils cherchent à démontrer, le nouveau traitement fait-il mieux, ou juste aussi bien qu’un traitement existant, et accepter une marge d’erreur définie. C’est un peu comme un sondage : interroger 20 personnes ne dit pas grand-chose, en interroger 2000 donne une image bien plus fiable. Les chercheurs visent généralement une puissance statistique de 80 à 90 %, c’est-à-dire 8 à 9 chances sur 10 de détecter un effet réel s’il existe. Et plus l’effet attendu du médicament est faible, plus il faut de participants pour le voir clairement.
Autre règle essentielle : l’analyse en intention de traiter. Elle oblige à compter tous les participants dans les résultats finaux, y compris ceux qui ont arrêté en cours de route ou n’ont pas suivi le protocole à la lettre, et à les garder dans leur groupe d’origine. Pourquoi est-ce si important ? Parce que sans cette règle, rien n’empêcherait d’écarter discrètement les cas qui se sont mal passés, pour ne garder que les bons résultats et gonfler artificiellement l’efficacité apparente du traitement. Plusieurs revues méthodologiques ont pourtant montré que cette règle est fréquemment mal appliquée, ou mal déclarée, un défaut que peu de lecteurs remarquent en parcourant une publication.

📖 À lire pour aller plus loin
Jean-Marc Sabatier, Marcel Gay
COVID-19 : LA CENSURE SCIENTIFIQUE : une enquête sur la mystification scientifique et l’étouffement de découvertes médicales, pour prolonger la réflexion amorcée dans cet article.
Découvrir le livre →Prix : 22,00 €
Hiérarchie des preuves et biais des essais
Toutes les études ne se valent pas, même quand elles arrivent toutes à la même conclusion en apparence. Les méthodologistes, notamment ceux du Centre for Evidence-Based Medicine d’Oxford, ont établi une sorte d’échelle de confiance : plus une étude sait isoler l’effet réel d’un traitement de tout le reste (le hasard, l’état de santé de départ, les habitudes de vie…), plus elle grimpe dans cette hiérarchie des preuves. Savoir où se situe une étude sur cette échelle aide à repérer un résultat présenté comme définitif, alors que sa méthode reste en réalité assez fragile.
Quels sont les niveaux de preuve clinique ?
Tout en haut de l’échelle, au niveau 1A : les méta-analyses rigoureuses, qui rassemblent plusieurs études sérieuses sur une même question. Viennent ensuite, dans l’ordre décroissant de fiabilité, les grands essais contrôlés randomisés, les petits essais randomisés, les études non randomisées, les études rétrospectives ou cas-témoins, puis, tout en bas de l’échelle, les simples opinions d’experts.
Ce niveau détermine le poids qu’on peut accorder à une conclusion : un essai de niveau 1A pèse beaucoup plus lourd, dans les recommandations médicales, qu’une étude rétrospective basée sur des dossiers patients examinés après coup.
Attention cependant à une idée reçue : une méta-analyse n’est pas automatiquement plus fiable simplement parce qu’elle combine plusieurs études. Sa solidité dépend entièrement de la qualité des travaux qu’elle rassemble. Plusieurs études biaisées ne s’annulent pas entre elles comme par magie : leurs défauts peuvent au contraire s’additionner. Et il existe un biais bien connu, le biais de publication : les revues scientifiques publient plus volontiers les résultats positifs que les résultats négatifs, ce qui déforme l’image d’ensemble qu’on se fait d’un traitement.
| Niveau | Type d’étude | Fiabilité |
| 1A | Méta-analyses correctes | Maximale |
| 1B | Grands essais contrôlés randomisés | Très élevée |
| 2 | Petits essais randomisés | Élevée, avec réserves |
| 3 | Essais comparatifs non randomisés | Modérée |
| 4 | Études rétrospectives, cas-témoins | Limitée |
| 5 | Opinions d’experts, essais sans contrôle | Faible |
Biais statistiques et forage de données
Imaginez que vous lanciez un dé vingt fois de suite en espérant un 6. Statistiquement, vous finirez par en obtenir un, sans que le dé soit truqué pour autant. Le forage de données fonctionne un peu pareil : en testant des dizaines de sous-groupes ou de critères différents sur les mêmes données (les femmes, les plus de 60 ans, ceux qui ont pris le traitement le matin…), il devient presque inévitable de tomber, par pur hasard, sur un résultat qui semble statistiquement significatif. Le problème, c’est que ce résultat ne prouve rien : il peut simplement venir du nombre de tentatives, pas d’un effet réel du traitement. Cette pratique favorise les faux positifs, difficiles à repérer pour un lecteur qui ne connaît pas les méthodes statistiques.
Trois notions qu’on confond souvent : la valeur p, la taille de l’effet observé et la puissance statistique. Elles ne racontent pas la même histoire. Un résultat « statistiquement significatif » (p inférieur à 0,05, le seuil habituel) ne suffit donc pas, à lui seul, à prouver qu’un traitement fonctionne réellement.
Lire une publication avec esprit critique
Même les revues les plus prestigieuses ne sont pas à l’abri d’une erreur, ou pire, d’une manipulation. Des articles parus dans The Lancet ou le New England Journal of Medicine ont ainsi été rétractés après avoir pourtant contribué à des décisions de santé publique. Les publications consacrées à l’hydroxychloroquine en fournissent un exemple documenté, notamment dans les analyses des Éditions marco pietteur sur les essais cliniques manipulés du vaccin Pfizer.
Alors, avant d’accepter une conclusion les yeux fermés, quelques questions simples à se poser : le protocole et le groupe de comparaison sont-ils clairement décrits ? Le critère principal était-il défini avant le début de l’essai, ou a-t-il changé en cours de route ? Les financements du promoteur sont-ils déclarés ? Poser ces questions ne relève pas d’une méfiance systématique envers la recherche : c’est simplement le réflexe qui permet de repérer un biais possible.
La randomisation, à elle seule, ne garantit donc pas la qualité d’un essai : c’est une pièce du puzzle, pas tout le puzzle. Il faut aussi regarder combien de participants ont abandonné en cours de route, ce qui a vraiment été mesuré, et si le résultat a une réelle importance clinique, pas seulement statistique. C’est souvent là que la lecture rapide s’arrête trop tôt.
Ce que la science officielle préfère minimiser
Rejoignez les lecteurs qui refusent les demi-vérités. Chaque semaine, l'information que les médias dominants préfèrent taire.
Du résultat statistique à la décision clinique
Une bonne étude ne suffit jamais, à elle seule, à trancher. La médecine fondée sur les preuves, c’est justement l’art de combiner les meilleures données disponibles avec l’expérience clinique du praticien : ni le simple avis d’un expert, ni une étude isolée, aussi bien conduite soit-elle, n’y suffisent. Même un essai solide a besoin d’être confirmé dans d’autres populations avant de pouvoir soutenir une conclusion définitive sur l’efficacité d’un traitement.
Le niveau de preuve donne donc un cadre pour juger, pas une réponse automatique. Avant de conclure, il vaut la peine de comparer les essais qui donnent un résultat positif à ceux qui n’en donnent pas : cette différence en dit souvent plus long que le chiffre mis en avant dans les communiqués de presse. La reproductibilité, c’est-à-dire le fait de retrouver le même résultat dans plusieurs études indépendantes, reste le test le plus exigeant, et parfois le plus révélateur.
Reconnaître un essai clinique légitime
Pour juger si un essai clinique mérite votre confiance, pas besoin d’être médecin ou statisticien. Il suffit de savoir où regarder : les registres officiels et quelques éléments précis sont accessibles à tout citoyen informé, sans formation médicale particulière.
Les critères d’un protocole transparent
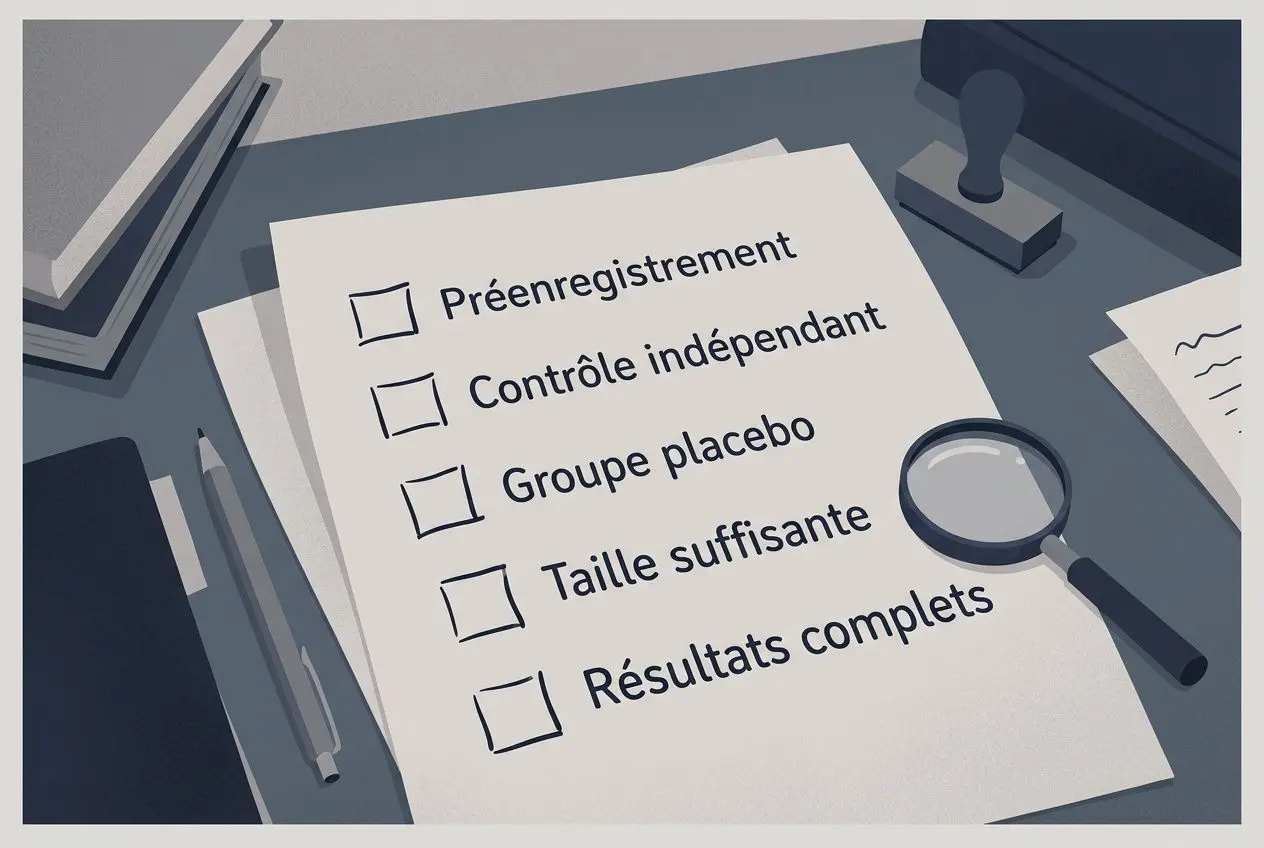
Premier réflexe à avoir : l’étude a-t-elle été enregistrée dans un registre public avant même le début du recrutement des patients ? Cette démarche engage le promoteur sur un protocole précis, un critère principal et une hypothèse, dès le départ. Toute modification ultérieure doit être déclarée et datée. Sans cet enregistrement préalable, la prudence s’impose.
- Des critères d’inclusion définis à l’avance : qui peut participer à l’étude, et qui en est exclu, doit apparaître dans le protocole dès le début. Modifier ces critères après coup peut orienter le groupe de patients vers un profil plus favorable au résultat espéré.
- Un critère principal unique et fixé à l’avance : une manipulation fréquente consiste à mesurer plusieurs critères de jugement, puis à ne mettre en avant, une fois l’analyse terminée, que celui qui donne un résultat positif. Ce genre de tour de passe-passe reste difficile à repérer sans consulter le protocole d’origine.
- La déclaration des conflits d’intérêts : qui a financé l’étude ? Les chercheurs ont-ils des liens financiers avec l’industrie pharmaceutique ? Ces informations doivent apparaître clairement dans la publication.
La population étudiée compte aussi énormément. Une étude menée uniquement sur de jeunes adultes en bonne santé ne permet pas d’affirmer la même efficacité, ni la même sécurité, chez les enfants, les personnes âgées, ou les patients qui ont d’autres pathologies. Les publications scientifiques sérieuses signalent généralement cette limite dans leur discussion. Les communiqués de presse, eux, la signalent beaucoup moins souvent.
Phases et surveillance clinique
Un essai clinique ne se déroule jamais d’un seul coup : il avance par phases numérotées de 0 à 4. Les phases 0 à 2 se concentrent sur la sécurité et le bon dosage ; les phases 3 et 4 évaluent l’efficacité sur des groupes de participants beaucoup plus larges. Ce découpage sert justement à écarter, étape par étape, ce qui se révèle inefficace ou dangereux, avant qu’un traitement n’arrive sur le marché.
Si un risque inacceptable apparaît en cours de route, le protocole prévoit l’arrêt immédiat de l’essai et l’information des autorités de contrôle. Les chercheurs sont tenus de déclarer tout événement indésirable imprévu. Un comité d’éthique indépendant, composé à la fois de spécialistes et de non-spécialistes, veille à ce que l’étude produise des données réellement utiles sans exposer les participants à des risques inutiles. Et ces derniers peuvent se retirer à tout moment, même après avoir signé leur consentement éclairé.
CAST, une leçon des essais contrôlés
L’histoire de l’essai CAST, interrompu en 1989, illustre parfaitement pourquoi une simple impression clinique peut tromper. Après un infarctus du myocarde, certains médicaments anti-arythmiques normalisaient l’électrocardiogramme des patients, un résultat qui rassurait les cardiologues de l’époque. Sauf que dans les faits, la mortalité atteignait 8,3 % dans les groupes traités, contre 3,5 % dans le groupe placebo, un écart hautement significatif (p = 0,0001).
Autrement dit : le médicament « corrigeait » bien un signe visible sur l’électrocardiogramme, mais il augmentait en réalité le risque de mourir. L’essai CAST a montré que l’amélioration d’un marqueur intermédiaire peut cacher une augmentation du risque de décès. Il a entraîné une contre-indication majeure et changé durablement la pratique cardiologique. La leçon à retenir : une thérapie ne se juge jamais sur l’amélioration isolée d’un paramètre biologique, mais sur le résultat clinique final, celui qui compte vraiment pour le patient.

📖 À lire pour aller plus loin
Naomi Wolf
PFIZER PAPERS : une analyse documentée des essais cliniques du vaccin Covid-19 de Pfizer, pour aller au-delà de l’exemple CAST et voir comment ces mêmes biais méthodologiques ont pu jouer à plus grande échelle.
Découvrir le livre →Prix : 35,00 €
Réglementation et accès aux essais cliniques
La transparence des essais cliniques ne repose pas seulement sur la bonne volonté de ceux qui les financent. En Europe comme aux États-Unis, des règles imposent l’enregistrement préalable des études et la publication de leurs résultats, même quand ils sont négatifs. Ces registres publics permettent à n’importe quel citoyen, ou professionnel, de vérifier qu’une étude existe bel et bien, quel était son protocole déclaré, et quelles données ont finalement été publiées.
Les registres publics des essais
En Europe, la réglementation s’appuie notamment sur EudraCT, la base de données de l’Agence européenne des médicaments, qui centralise les informations sur les essais de médicaments menés sur le territoire européen. Depuis juillet 2014, des résumés de résultats y sont accessibles au public. Et pour les essais commencés dans l’Union européenne à partir du 1er janvier 2015, publier les résultats est devenu obligatoire, qu’ils soient favorables au traitement ou non.
- EudraCT (Europe) : la base de l’Agence européenne des médicaments, avec publication obligatoire des résultats depuis 2015.
- ClinicalTrials.gov (États-Unis) : le registre américain équivalent, avec la même logique d’enregistrement préalable et de diffusion publique des données.
- ICTRP (OMS) : l’Organisation mondiale de la santé y définit des normes internationales communes pour l’enregistrement et la présentation des résultats, partout dans le monde.
- Résultats négatifs : les publier permet de limiter le biais de publication, qui donnerait sinon une image artificiellement favorable d’un médicament en ne laissant voir que les essais positifs.
Un conseil simple : si un essai n’a pas été enregistré avant le début du recrutement des patients, gardez une réserve sérieuse, même si l’institution a une grande réputation, ou si l’étude est publiée dans une revue reconnue.
Participer à une étude clinique
Les essais cliniques ne s’adressent pas uniquement aux patients en situation critique. Des volontaires en bonne santé peuvent eux aussi y participer, notamment pour des études sur la contraception, ou lors de l’évaluation d’un nouveau médicament à un stade précoce. La plupart de ces études se déroulent en ambulatoire : les participants se rendent simplement à la clinique lors des visites prévues, ce qui limite les contraintes et permet parfois de recruter simultanément sur plusieurs sites.
Avant de vous engager, vérifiez que l’étude est bien enregistrée dans un registre public. Prenez le temps de lire les critères d’éligibilité, le calendrier des visites et les risques déclarés. Le consentement éclairé doit correspondre à une vraie compréhension de ce qui vous attend, pas à une signature expédiée entre deux portes.
Un essai clinique peut aussi donner accès à une thérapie expérimentale avant sa mise sur le marché. Cette possibilité comporte une incertitude bien réelle, puisque l’innocuité complète du traitement n’est pas encore totalement établie. La meilleure protection, dans ce contexte, reste un groupe de patients correctement informés, suivis par un comité d’éthique actif et par des chercheurs qui signalent honnêtement les événements indésirables. Les registres, à eux seuls, ne garantissent pas la qualité d’une étude, mais ils permettent au moins de vérifier qu’elle existe, que son protocole est consultable, et que ses résultats ont vocation à être rendus publics.
📖 Pour aller plus loin
Naomi Wolf
PFIZER PAPERS : pour appliquer concrètement les critères présentés ici à l’un des dossiers les plus documentés et les plus controversés de ces dernières années.
Découvrir le livre →Prix : 35,00 €
Foire aux questions
Un essai clinique randomisé garantit-il des résultats fiables ?
Oui, en grande partie, mais ce n’est pas une garantie absolue. Un essai clinique contrôlé et randomisé, mené en double aveugle et analysé en intention de traiter, correspond au niveau de preuve le plus élevé en recherche médicale, le niveau 1A. C’est un cadre solide, pas une certitude à 100 %. Le choix du critère principal, la sélection des participants, la façon d’analyser les données ou de publier, ou non, les résultats négatifs peuvent tous introduire des biais, volontaires ou non. Un protocole solide réduit fortement le risque d’erreur. Il ne l’annule pas complètement.
Comment détecter qu’un essai clinique a été biaisé ou manipulé ?
Plusieurs indices doivent mettre la puce à l’oreille : l’absence d’enregistrement préalable dans un registre public comme EudraCT ou ClinicalTrials.gov, un critère principal qui semble avoir changé après le début de l’étude, des participants exclus sans justification claire, ou des résultats favorables publiés alors que les données brutes restent, elles, inaccessibles. Le forage de données, qui consiste à tester de nombreuses hypothèses jusqu’à obtenir un résultat qui paraît significatif, est particulièrement difficile à repérer sans consulter le protocole de départ.
Peut-on se fier aux méta-analyses publiées dans de grandes revues médicales ?
Oui, mais pas les yeux fermés. Une méta-analyse peut renforcer le résultat observé dans une étude isolée, à condition que les essais qu’elle rassemble soient eux-mêmes suffisamment rigoureux. Sinon, leurs défauts s’additionnent au lieu de s’annuler. Le biais de publication joue aussi : les essais positifs sont publiés plus souvent que ceux qui ne trouvent aucun effet. Des rétractations parues dans The Lancet et le New England Journal of Medicine le rappellent bien : le prestige d’une revue ne dispense jamais d’examiner sa méthode.
Qu’est-ce que le forage de données (p-hacking) ?
Imaginez que vous lanciez un dé vingt fois en espérant un 6 : statistiquement, vous finirez par en obtenir un, sans que le dé soit truqué. Le forage de données fonctionne pareil : en testant des dizaines de sous-groupes différents sur les mêmes données (les femmes, les plus de 60 ans, ceux traités le matin…), on finit presque toujours par tomber sur un résultat qui a l’air significatif, par pur hasard. Cela ne prouve rien : cela vient du nombre de tentatives, pas d’un effet réel. Consulter le protocole d’origine, pour vérifier que le critère principal était bien défini avant le début de l’essai, reste le meilleur moyen de repérer cette manipulation.
Que montre l’exemple de l’essai CAST ?
L’essai CAST, interrompu en 1989, a montré que des anti-arythmiques normalisant l’électrocardiogramme après un infarctus du myocarde augmentaient en réalité la mortalité : 8,3 % dans les groupes traités, contre 3,5 % dans le groupe placebo (p = 0,0001). Il illustre à merveille pourquoi l’amélioration d’un marqueur intermédiaire peut cacher une augmentation bien réelle du risque de décès, et pourquoi une thérapie doit toujours être jugée sur le résultat clinique final, pas sur l’amélioration isolée d’un paramètre biologique.